Modell der Woche
Claude Opus 5 knackt FreeCAD und baut sich seine eigenen Werkzeuge
Anthropic hat Opus 5 veröffentlicht. Es löst Aufgaben, an denen andere Modelle aussteigen, und halluziniert dabei 14 Punkte häufiger als sein Vorgänger.
 Thomas Reigl Aktualisiert 4 Min. Lesezeit
Anthropic hat dem neuen Modell in FreeCAD, einem Konstruktionsprogramm, die technische Zeichnung eines Maschinenteils vorgelegt. Lesen konnte es das Bild nicht, diese Fähigkeit hatte es nicht.
Also hat es sich eine geschrieben. Das Modell programmierte eine eigene Bilderkennung, die aus den rohen Pixeln die Geometrie herausliest, und rekonstruierte damit das Bauteil. Andere Modelle gaben bei derselben Aufgabe nach fünf Anläufen auf.
Der Sprung steht in keiner Benchmark-Tabelle: Wenn diesem Modell ein Werkzeug fehlt, hört es nicht auf, sondern baut sich eins.
Was vorher nicht ging
Modelle scheitern selten an einem einzelnen Schritt. Sie scheitern an der Lücke dazwischen, wenn ein Format nicht passt oder dem Export drei Spalten fehlen, und am Ende steht ein höflicher Absatz statt eines Ergebnisses.
Auf einen Vorgang im Haus übersetzt: Der Auftrag kommt als PDF, die Positionen sollen ins ERP, und eine davon steht nicht in der Artikelliste. Die letzte Generation meldet hier zurück. Diese sucht sich einen Weg drumherum. Praktisch, solange jemand nachsieht, welchen sie genommen hat.
Die Zahlen
| Test | Was gemessen wird | Opus 5 | Vergleich |
|---|---|---|---|
| Frontier-Bench v0.1 | mehrschrittige Arbeit im Terminal, vom Fehler bis zum fertigen Feature | 43,3 % | Opus 4.8: 18,7 %, Fable 5: 33,7 %, GPT-5.6 Sol: 37,5 % |
| ARC-AGI 3 | Aufgabentypen ohne Anleitung und ohne genanntes Ziel | 30,2 % | Opus 4.8: 1,5 %, GPT-5.6 Sol: 7,8 % |
| Intelligence Index (Artificial Analysis) | neun Prüfungen zusammengefasst | 61, Platz 1 von 184 | Fable 5: 60, Kimi K3: 57, Opus 4.8: 56 |
| Capabilities Index (Epoch AI) | dasselbe Ziel, andere Methode | 159 | Fable 5: 161 |
| Kosten je Aufgabe | was ein erledigter Vorgang kostet | 2,03 $ | Fable 5: 2,75 $, Opus 4.8: 1,80 $ |
Claude Fable 5 ist übrigens kein Konkurrenzprodukt, sondern Anthropics eigenes Spitzenmodell, doppelt so teuer bei 10 und 50 Dollar je Million Token. Wenn Opus 5 dessen Bestwert überholt, gewinnt kein Herausforderer gegen den Marktführer. Ein Hersteller ordnet seine eigene Produktlinie neu.
Die beiden unabhängigen Auswerter sind sich nicht einig. Artificial Analysis sieht Opus 5 vorn, Epoch AI dahinter, und Artificial Analysis hat Anthropic nach eigener Angabe vor dem Start bei der Bewertung unterstützt. Ich gewichte Epoch deshalb höher, ohne die 61 Punkte abzutun.
Die höchste Aufwandsstufe ist im Übrigen nicht die beste. Fünf gibt es, von low bis max, und sie legen pro Anfrage fest, wie lange das Modell nachdenkt. Auf Frontier-Bench liegt xhigh mit 44,4 Prozent vor max mit 43,3, weil max laut Anthropics Dokumentation zum Überdenken führen kann.
Der Haken
Die Halluzinationsrate ist um rund 14 Punkte gestiegen, auf etwa 50 Prozent bei Wissensfragen, die das Modell nicht sicher beantworten kann. Der Grund ist dieselbe Eigenschaft wie im ersten Absatz: Das Modell antwortet lieber, als zuzugeben, dass es nicht weiterweiß. Es antwortet außerdem länger, und auf der höchsten Stufe vergehen 80 Sekunden bis zum ersten Wort.
Was am Maschinenteil beeindruckt, ist bei einer Vertragsfrage ein Problem.
In der Codeprüfung wird das am deutlichsten. CodeRabbit hat Opus 5 an 96 Fehlermustern aus echten Open-Source-Projekten getestet, und das Ergebnis geht in beide Richtungen gleichzeitig:
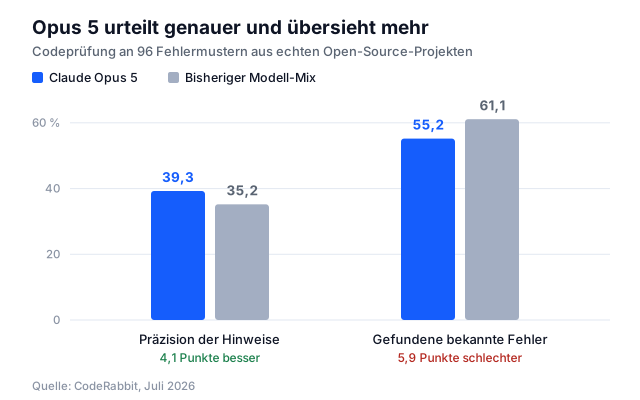
Eigene Darstellung, Daten aus dem Modell-Review von CodeRabbit, Juli 2026. Gemessen an 96 Fehlermustern aus echten Open-Source-Projekten, drei Durchläufe je Konfiguration.
Die höchste Präzision, die CodeRabbit je gemessen hat, und trotzdem findet das Modell weniger der bekannten Fehler als der Mix davor. Das Urteil dort: ein Präzisionsspezialist, der ein breiter suchendes zweites Modell daneben braucht.
Was das für dich heißt
CodeRabbit hat Opus 5 die höchste Präzision bescheinigt, die dort je gemessen wurde, und zieht daraus trotzdem den Schluss, dass es ein zweites, breiter suchendes Modell daneben braucht.
Ein Modell, das nie aufgibt, beantwortet auch die Frage, bei der es geraten hat. Von außen sehen beide Antworten gleich aus, gleich flüssig und gleich selbstbewusst. Der Unterschied wird erst sichtbar, wenn die Antwort sagt, worauf sie sich stützt.
Genau da setzt RelationFlow an: Antworten kommen aus dem Wissen deines Unternehmens und nennen ihre Quelle. Warum ein Modell nie reicht, steht ausführlicher an anderer Stelle.
Quellen: Anthropic zu Claude Opus 5, Migrationsleitfaden und Effort-Dokumentation. Unabhängig gemessen: Artificial Analysis, Epoch AI (zitiert nach the-decoder) und CodeRabbit. Benchmark-Einordnung nach Vellum. Anthropic veröffentlicht die eigenen Benchmarks nur als Diagramm, die Prozentwerte sind abgelesen.